
Sistema para preguntar en lenguaje natural a los documentos de la empresa: contratos, informes y hojas de cálculo. Ingesta automática con n8n, búsqueda semántica sobre Supabase con pgvector y la decisión abierta de dónde se procesa el dato.
Una empresa acumula contratos, informes, procedimientos y hojas de cálculo. La información está, pero encontrarla exige saber en qué carpeta y en qué página mirar. Buscar por nombre de fichero no sirve cuando la pregunta es qué dice un contrato concreto sobre las penalizaciones por retraso.
Un sistema RAG (retrieval augmented generation) en dos mitades, montado sobre n8n y Supabase.
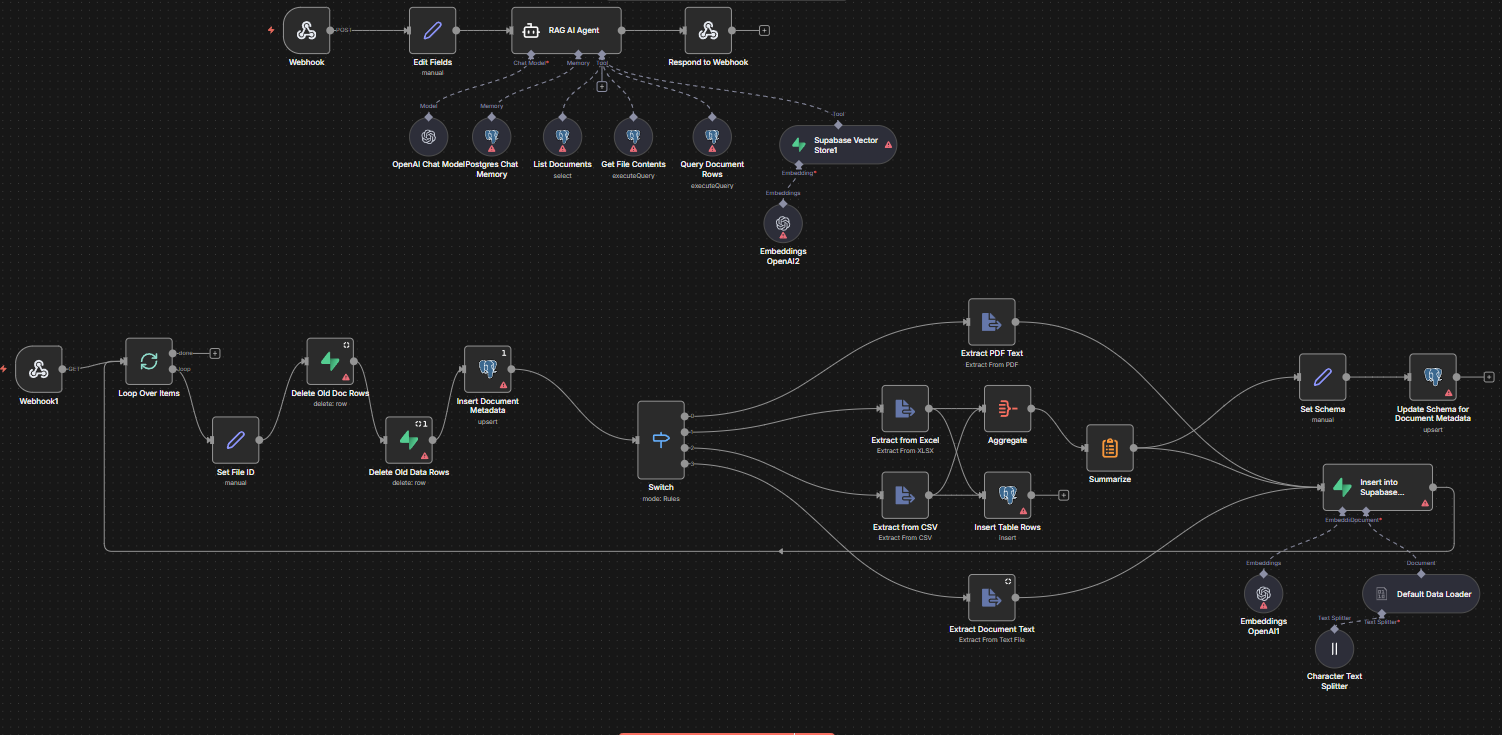
Los documentos entran por un webhook y el flujo se encarga del resto: extrae el texto según el tipo de fichero (PDF, Excel, CSV o documento de texto), lo parte en fragmentos, calcula los vectores de cada fragmento y los guarda en Supabase con pgvector. De las hojas de cálculo guarda además las filas y su esquema, para poder consultarlas como datos y no solo como texto. Cuando un documento se vuelve a subir, sus filas anteriores se borran antes de insertar las nuevas, así que una versión vieja no se queda respondiendo.
Un agente recibe la pregunta y elige cómo contestarla: búsqueda semántica sobre los fragmentos cuando es una pregunta de contenido, o consulta directa a las filas cuando es de datos. Puede listar los documentos disponibles y leer uno entero si hace falta, y mantiene el hilo de la conversación en Postgres. Se expone por webhook, así que se enchufa al chat interno o a la herramienta que el equipo ya tenga abierta.
Es la decisión que conviene tomar el primer día, porque condiciona el resto.
La versión montada usa la API de OpenAI para el modelo de chat y para los vectores. Es la opción más capaz hoy y la más rápida de poner en pie, y significa que el texto de los documentos viaja a un proveedor externo.
Cuando eso no vale, y en cierta documentación no vale, la misma arquitectura se despliega con modelos open source en un servidor propio y Supabase autoalojado. Se pierde capacidad frente a los modelos grandes y hay que pagar y mantener el hardware, pero el documento no sale de la red del cliente.
Lo demás no cambia: la ingesta, el troceado, la base vectorial y el agente son los mismos. Por eso la elección se puede revisar más adelante sin rehacer el sistema.